人形机器人通过一条软件链交谈:麦克风收音,语音识别把声音转成文字,语言模型根据人设和活动知识写出回答,语音合成再把它说出来。对话质量取决于软件、事先准备的知识和场地声学条件,而不只是机器人本身。
目录
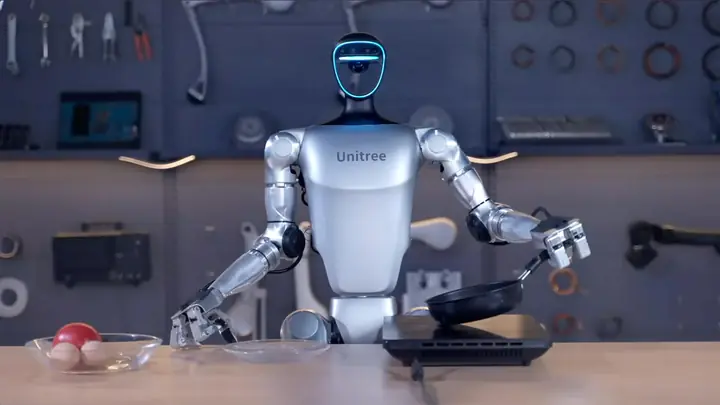
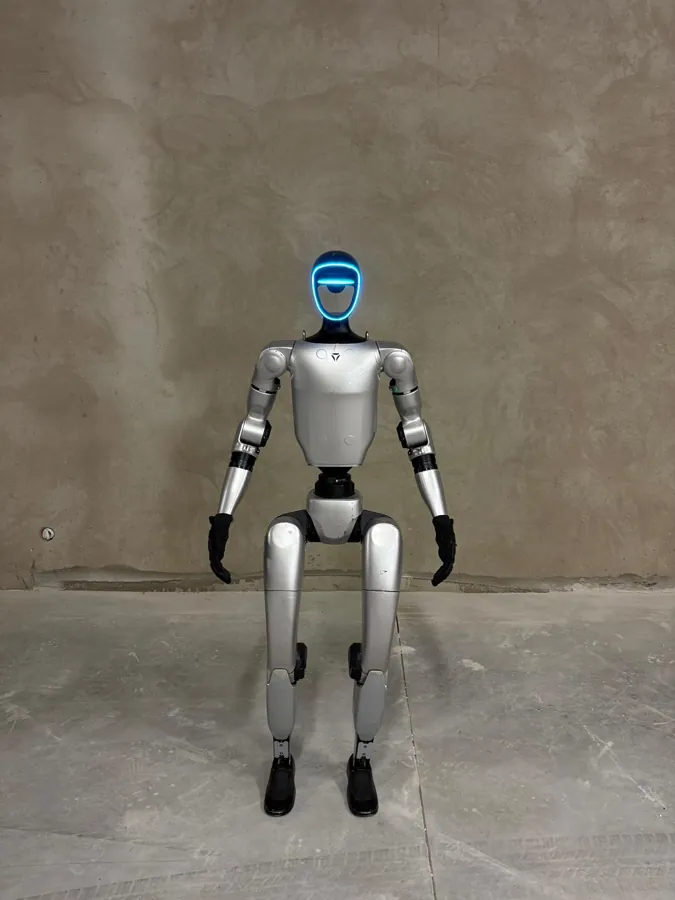
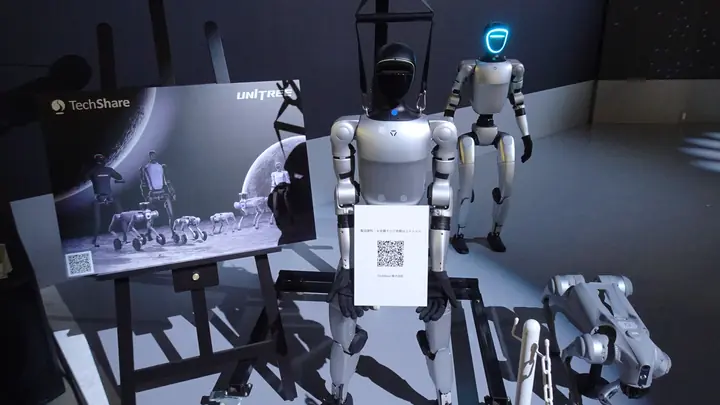
与人形机器人的对话是怎样一步步进行的?人形机器人能听到什么,如何应对噪音?人形机器人怎么知道该说什么?为什么机器人的回应速度这么重要?人形机器人能用多少种语言,用什么样的声音?必须告诉人们他们在与人工智能交谈吗?举办有会说话的机器人的活动之前,应该检查什么?如何选择人形机器人对话的合作伙伴?人形机器人通过一条软件链与人交谈:麦克风收音,语音识别把声音转成文字,语言模型根据机器人的人设和它对活动的了解写出回答,语音合成再把回答变成您从扬声器里听到的声音。机器人本身(例如 Unitree G1)提供“耳朵”“嘴巴”和动作;对话质量取决于软件,以及软件针对具体场地准备得有多好。
与人形机器人的对话是怎样一步步进行的?
与人形机器人的对话经过五个阶段,每一轮交流都会重复一遍:
| 阶段 | 发生了什么 | 质量取决于什么 |
|---|---|---|
| 收听 | 机器人的麦克风(或外接麦克风)收音 | 噪音、与说话人的距离、房间回声 |
| 轮次判断 | 系统判断一个人何时开始、何时说完 | 灵敏度设置、背景人声 |
| 语音识别 | 把语音转成文字 | 语言、口音、专有名称、儿童的声音 |
| 回答 | 语言模型借助人设和知识写出回答 | 人设说明和知识库的质量、话题规则 |
| 声音和动作 | 语音合成、扬声器、手势 | 与语言匹配的声音、音量、场馆扩声 |
任何一环薄弱,整条链都会断。活动上最常见的问题不是“人工智能太笨”,而是机器人在嘈杂的人声中听错了问题,然后准确地回答了一个没人问过的问题。
人形机器人能听到什么,如何应对噪音?
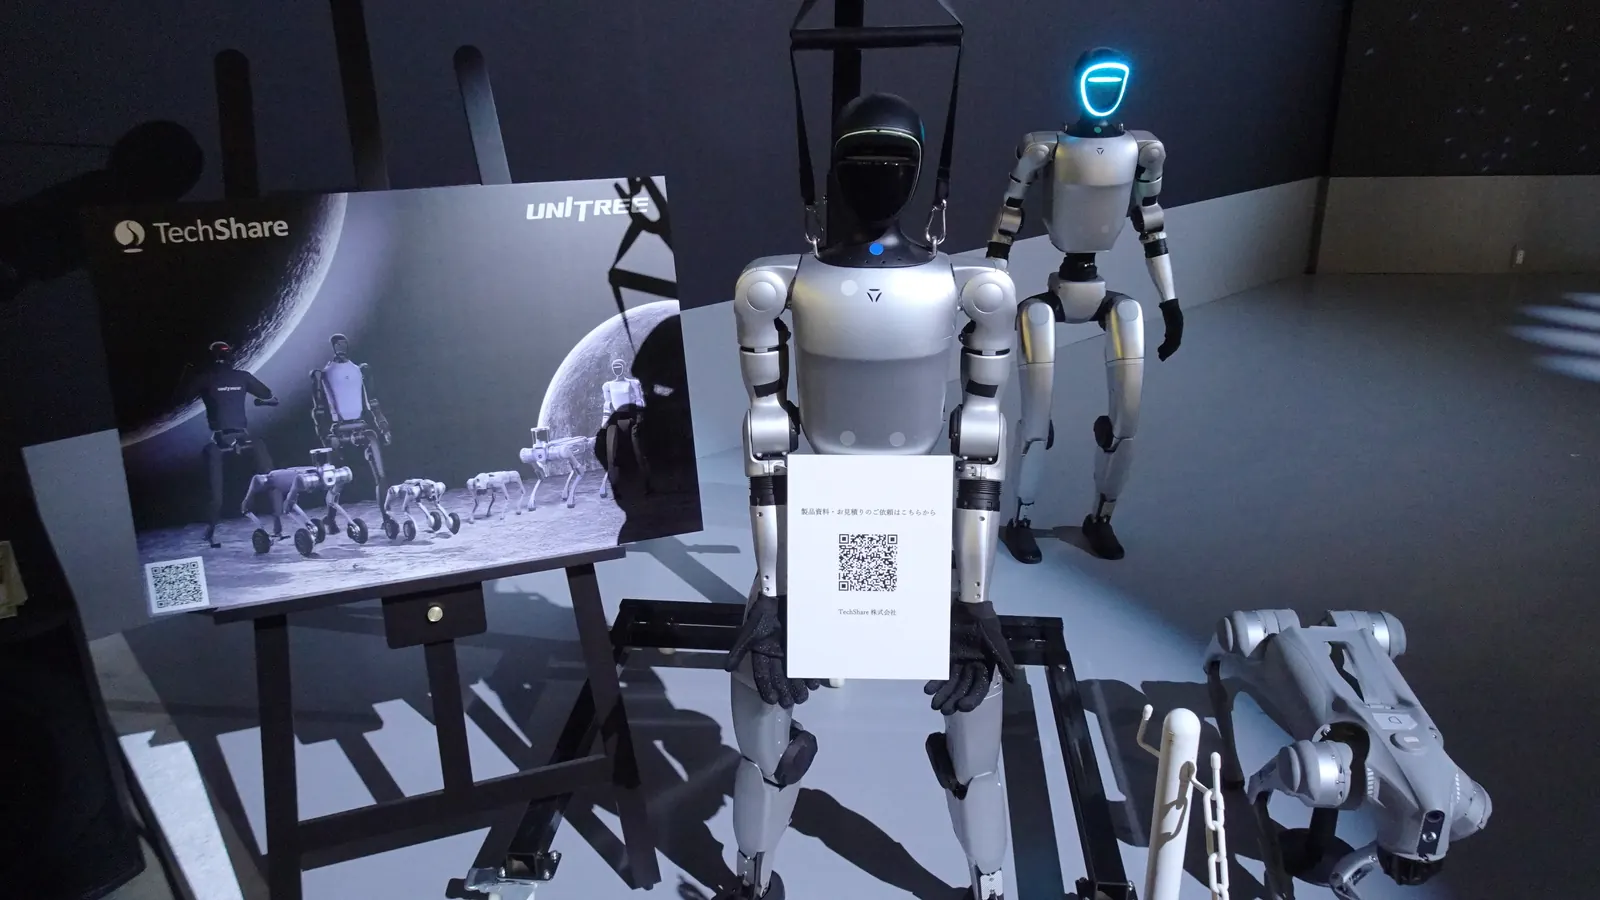
人形机器人通过内置的麦克风阵列收听;在嘈杂的场馆里,在说话人嘴边加一支麦克风往往效果更好。根据制造商的资料,Unitree G1 配有“4 Microphone Array”和“5W Speaker”,即四个麦克风和一个 5 W 扬声器(Unitree G1 参数)。这足以在办公室、展厅或安静的展台上进行对话。
到了展会、晚会或音乐节,情况就不同了:音乐、舞台扩声和许多同时进行的对话都会传到同一组麦克风里。实际有用的做法包括:
- 来宾走近机器人,正对着它说话,而不是从侧面说,
- 为舞台和圆桌讨论中的来宾准备手持麦克风或指向性麦克风,
- 把展台设在远离舞台扬声器的位置,
- 提前把专有名称(品牌、产品、演讲嘉宾姓名)告诉系统,以免语音识别把它们弄错,
- 在实际场馆里测试,而不只是在办公室里测试。
声音输出也一样:一对一交谈时,机器人内置的扬声器就够用;但登台表演时,机器人的声音需要接入场馆的扩声系统。
人形机器人怎么知道该说什么?
人形机器人的回答由语言模型写出,模型会收到人设描述、关于活动的知识,以及机器人不能说什么的规则。模型懂语言,也了解世界的一般情况,但它对会议议程、客户的产品或衣帽间在哪里一无所知。这些知识必须提前准备。
一套好的准备材料包括:
- 人设:名字、性格、说话方式、回答长度,
- 知识:议程、演讲嘉宾、产品和服务、来宾常见问题的答案,
- 边界:禁谈话题、如何婉拒、遇到政治或竞争对手相关问题时怎么办,
- 脚本:问候、邀请合影、把来宾交给展台上的工作人员。
MERA Robotics 就是这样工作的:机器人的话语针对每场活动,在包含客户和活动议程知识的活动档案中准备;机器人还可以拥有自己的品牌形象,包括名字、性格和对产品与服务的了解。
有些系统会把对话与摄像头画面结合起来。这时,机器人能识别面前的物体,例如展出的某个产品型号,并在对话中提到它。这在展厅和展台上很有用,因为来宾常会问:“这是什么?”
为什么机器人的回应速度这么重要?
人形机器人的回应速度决定了对话是否自然,因为人们习惯了轮次之间极短的间隔。发表在《美国国家科学院院刊》(PNAS)上的一项涵盖 10 种语言的研究发现,在每一种语言中,从一方说完到另一方开始回答,最常见的间隔都非常短,几乎是无缝衔接(Stivers 等,PNAS 2009)。
由语音识别、语言模型和语音合成组成的软件链,没有一条能像人一样快速回答,因此机器人系统要靠对话的组织方式来弥补:
- 回答还没完全生成,就开始播放,
- 用简短的回答代替长篇独白,
- 问题一说完,机器人就做一个手势或转一下头,让来宾知道它在听,
- 允许在机器人说话时打断它。
第二个问题是机器人判断对方已经说完的时机。判断得太早,机器人会在对方每次停下来思考时插话;判断得太晚,来宾只能在沉默中等待。这一设置应与观众相匹配:儿童和说外语的人停顿时间更长。
人形机器人能用多少种语言,用什么样的声音?
语言数量和声音选择取决于人形机器人的对话软件,而不是机器人硬件。MERA Robotics 开发的对话系统 MERA OS 能用 70 多种语言对话,包括波兰语和英语,每种语言都配有相应的声音和母语口音。在国际活动上,机器人可以用英语问候一位来宾,再用波兰语与下一位来宾交谈。
选择声音时,请检查:
- 声音是否符合人设(年龄、气质、品牌),
- 在这种语言里听起来是否自然,而不像是从英语翻译过来的,
- 它如何读出客户的专有名称,
- 在噪音中语速是否仍然听得懂。
必须告诉人们他们在与人工智能交谈吗?
必须:在欧盟,告知人们正在与人工智能交谈的义务来自《人工智能法》第五十条,该条自 2026 年 8 月 2 日起适用。它要求用于与人直接互动的人工智能系统,在设计上必须让这些人知道自己在与人工智能系统互动,除非这一点显而易见(《人工智能法》第五十条、关于生效和适用的条款)。这一信息必须清楚,并最迟在首次互动时提供。
面对人形机器人,人们通常一眼就能看出是机器在说话。不过,在机器人的问候语里加一句话,或在展台上放一块提示牌,既简单又能消除任何疑问。数据则是另一个问题:如果对话会被录音或记录,来宾应当知情。
举办有会说话的机器人的活动之前,应该检查什么?
举办有会说话的人形机器人参与的活动之前,请检查七件事:
- 在实际场馆或类似噪音环境中做一次对话测试。
- 一份机器人必须能识别并正确读出的专有名称清单。
- 经客户认可的人设和回答长度。
- 一份禁谈话题清单,以及机器人婉拒的方式。
- 舞台方案:给来宾的麦克风、与扩声系统的连接。
- 一条告知来宾他们在与人工智能交谈的提示。
- 现场有一位操作员,可以接管对话、切换语言或让机器人停下。
可用于活动的机型见出租和在售的机器人目录。
如何选择人形机器人对话的合作伙伴?
评估人形机器人对话的合作伙伴,可以使用签约前就能核实的标准:
- 自有对话软件,而不是制造商那款单一、死板的应用,
- 语言数量,以及声音在您的语言里听起来有多自然,
- 为您的活动准备的人设和知识,而不是通用的聊天机器人,
- 现场操作员,出问题时能及时应对,
- 可以租用或购买的机器人机型,
- 国内外的活动经验。
常见问题
人形机器人能听懂人们对它说的话吗?
人形机器人把语音转成文字,再由语言模型理解意思并写出回答。它能听懂用自然语言提出的问题,但关于具体活动、产品或议程的知识必须提前准备。
为什么机器人有时会答非所问?
通常是因为它在噪音中听错了问题:语音识别记下了别的词,模型则准确地回答了这个被转写错的问题。走近说话、给来宾配麦克风、提前把专有名称告诉系统,都会有帮助。
人形机器人能在一场活动中说几种语言吗?
能,前提是对话软件支持。MERA Robotics 的系统 MERA OS 能用 70 多种语言对话,包括波兰语和英语,每种语言都配有相应的声音。
必须告诉来宾他们在与人工智能交谈吗?
在欧盟,《人工智能法》第五十条自 2026 年 8 月 2 日起适用,要求告知与人工智能系统直接互动的人,除非这一点显而易见。面对人形机器人,在问候语里加一句话,或在展台上放一块提示牌,通常就够了。